Table des matières
AudioTranscript : Des segments WAV à la transcription
AudioTranscript découpe un enregistrement WAV autour des silences, transmet les segments à un service de reconnaissance et rassemble le texte. L’implémentation utilise Amazon, même si ses docstrings mentionnent encore Google.
- Langages
- 1Répartition du code
- Composants documentés
- 2Explorer les modules
- Documents source
- 1Lire les instructions
Langages du dépôtPython 100%1
Parts calculées à partir des octets GitHub Linguist.
| Langage | % | Octets |
|---|---|---|
| Python | 6 443 |
1. Aperçu
1.1. Pourquoi il existe
Pipeline de traitement et de transcription audio avec alignement temporel.
1.2. Cas d’usage
Transcription automatique par lots d'enregistrements audio.
2. Cas d’utilisation
CLI Python qui découpe un fichier WAV aux silences et transcrit chaque segment pour former un seul texte.
- Découper l’audio aux silences
- Utilisateur de la CLI
main.py charge le WAV avec pydub et appelle split_on_silence avec --min-silence-len, --silence-thresh (relatif au dBFS du fichier) et --keep-silence, puis écrit chaque morceau dans audio-chunks/chunkN.wav.
- Transcrire les segments
- Utilisateur de la CLIAmazon Transcribe
Chaque segment passe par recognize_amazon (us-east-1, compartiment S3 du .env) et les textes sont joints puis affichés. Le README parle de Google Speech Recognition, mais le code appelle Amazon ; l’option --language n’est pas transmise.
- Mettre les clés AWS dans .env
- Utilisateur de la CLIAmazon Transcribe
load_dotenv lit AWS_ACCESS_KEY_ID, AWS_SECRET_ACCESS_KEY et AWS_BUCKET_NAME ; main.py lève une erreur si l’une manque.
- Tester Whisper sur un exemple
- Utilisateur de la CLIHugging Face Hub
ai.py est un script à part qui charge openai/whisper-large-v2 avec transformers et transcrit un échantillon LibriSpeech de test ; il n’est pas relié à la CLI et ses paquets ne figurent pas dans requirements.txt.
2.1. Scénario : Transcrire une entrevue enregistrée
- Lancer pip install -r requirements.txt, puis python-dotenv, que main.py importe mais que le fichier n’inclut pas.
- Créer un fichier .env avec AWS_ACCESS_KEY_ID, AWS_SECRET_ACCESS_KEY et AWS_BUCKET_NAME.
- Lancer python main.py entrevue.wav -m 700 -s -16 (le chemin est positionnel, caro.wav par défaut).
- main.py écrit les segments dans audio-chunks/ et affiche une barre de progression Rich.
- Chaque segment est envoyé à Amazon Transcribe et le texte complet s’affiche à la fin.
Fichiers consultésREADME.mdmain.pyai.pyrequirements.txt
3. Démarrage
Ces commandes viennent de la documentation du dépôt. Elles n’ont pas été exécutées pendant cette revue.
python main.py --path <audio_file_path> --min-silence-len <min_silence_length> --silence-thresh <silence_threshold> --keep-silence <keep_silence_duration> --language <language_code>4. Références du dépôt
Extraits des guides du dépôt, dans leur langue d’origine. Les liens ouvrent la version du code consultée.
Prérequis et premier essai
4.1. Requirements
README.md
- Python 3.x
- pydub
- speech_recognition
- rich
- typer
- dotenv
4.2. Installation
README.md
- Clone the repository
- Navigate to the project directory
- Install the required packages
- Create a .env file and add your AWS credentials
Configuration et utilisation
4.3. Usage
README.md
4.4. Parameters:
README.md
- –path: Path of the audio file to transcribe.
- –min-silence-len: Minimum length of silence required to detect the end of a speech segment in milliseconds.
- –silence-thresh: Threshold value in dBFS below which the audio is considered silent.
- –keep-silence: Duration of silence to be kept at the beginning and end of each chunk in milliseconds.
- –language: Language code of the audio file to be transcribed.
Développement et contributions
4.5. Contributing
README.md
5. Fonctions et composants 2
- Découpage audio
- main.py charge un WAV avec pydub et appelle split_on_silence. Le seuil est calculé par rapport au niveau dBFS de l’enregistrement. Chaque segment est exporté dans audio-chunks avant la reconnaissance.
- Reconnaissance et sortie
- Un Recognizer de SpeechRecognition lit chaque fichier exporté et appelle recognize_amazon. La boucle ajoute le résultat à whole_text, ensuite affiché et retourné. Typer expose le fichier et les paramètres de découpage.
6. Architecture
Ouvrez un composant pour suivre ses connexions, ou explorez le diagramme complet.
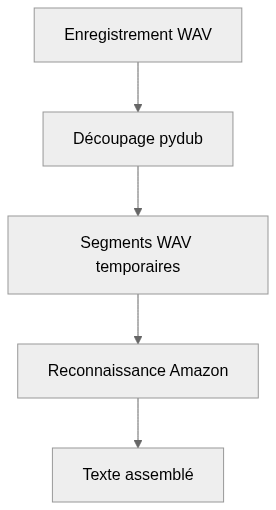
Enregistrement WAV
- Vers Découpage pydub
Découpage pydub
- Depuis Enregistrement WAV
- Vers Segments WAV temporaires
Segments WAV temporaires
- Depuis Découpage pydub
- Vers Reconnaissance Amazon
Reconnaissance Amazon
- Depuis Segments WAV temporaires
- Vers Texte assemblé
Texte assemblé
- Depuis Reconnaissance Amazon
Mermaid Diagramme interactif
Vue générale des composants et des échanges vérifiés dans le dépôt.
flowchart LR
  n0["Enregistrement WAV"]
  n1["Découpage pydub"]
  n2["Segments WAV temporaires"]
  n3["Reconnaissance Amazon"]
  n4["Texte assemblé"]
  n0 --> n1
  n1 --> n2
  n2 --> n3
  n3 --> n4
Version texte du diagramme
- Enregistrement WAV → Découpage pydub
- Découpage pydub → Segments WAV temporaires
- Segments WAV temporaires → Reconnaissance Amazon
- Reconnaissance Amazon → Texte assemblé
Suivre un parcours dans le code
Suivez transcribe_audio_file plutôt que sa docstring: la fonction vérifie les variables AWS juste avant recognize_amazon. L’argument de langue est exposé par la CLI, sans être transmis à cet appel.
7. Dossier technique
Établi à partir du code au commit 91b458e (4 fichiers). Chaque élément vient d’une correspondance de motif dans le code: ouvrez le fichier lié avant de vous y fier.
7.1. Couches et modules
Les dossiers sont classés par couche selon leur nom, de l’interface utilisateur jusqu’à l’accès aux données. Comme le classement repose sur les noms seulement, le diagramme ne dit rien des appels entre couches.
Mermaid Vue en couches
flowchart TB
  subgraph L_interface["Points d’entrée et API"]
    direction TB
    interface_0["(root)<br/>1 fichier"]
  end
  subgraph L_core["Source principale"]
    direction TB
    core_0["(root)<br/>1 fichier"]
  end
  L_interface ~~~ L_core
| Module | Couche | Fichiers | Types | Extensions |
|---|---|---|---|---|
(root) | Source principale | 2 | 0 | .py |
7.2. Modèle C4
Du contexte du système aux déclarations du code. Chaque niveau conserve les limites des sources disponibles.
UML 1 · Contexte du système
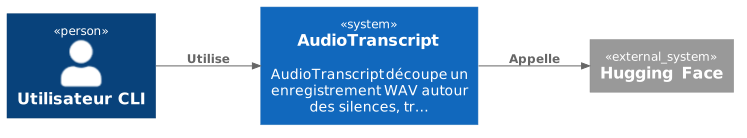
La vue C4 la plus large : qui utilise le projet et sur quels systèmes et stockages externes il s’appuie. Rendu avec uml-mcp.
Source PlantUML
@startuml
!include <C4/C4_Context>
LAYOUT_LEFT_RIGHT()
Person(P_cli, "Utilisateur CLI")
System(SYS, "AudioTranscript", "AudioTranscript découpe un enregistrement WAV autour des silences, tr…")
System_Ext(E0, "Hugging Face")
Rel(P_cli, SYS, "Utilise")
Rel(SYS, E0, "Appelle")
@enduml
UML 2 · Conteneurs
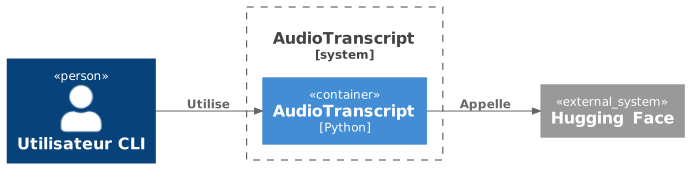
Un niveau plus près : les parties qui s’exécutent séparément dans le projet, leur langage principal et le chemin des appels entre elles. Rendu avec uml-mcp.
Source PlantUML
@startuml
!include <C4/C4_Container>
LAYOUT_LEFT_RIGHT()
Person(P_cli, "Utilisateur CLI")
System_Boundary(SYS, "AudioTranscript") {
  Container(APP, "AudioTranscript", "Python")
}
System_Ext(E0, "Hugging Face")
Rel(P_cli, APP, "Utilise")
Rel(APP, E0, "Appelle")
@enduml
UML 3 · Composants et couches
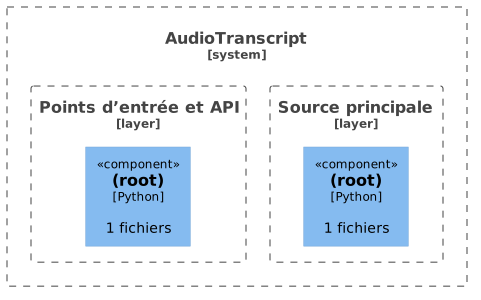
Modules regroupés par couche du code. Les limites indiquent l’organisation, sans affirmer une isolation à l’exécution ni des appels. Rendu avec uml-mcp.
Source PlantUML
@startuml
!include <C4/C4_Component>
LAYOUT_TOP_DOWN()
System_Boundary(SYS, "AudioTranscript") {
Boundary(L0, "Points d’entrée et API", "layer") {
Component(M0_0, "(root)", "Python", "1 fichiers")
}
Boundary(L1, "Source principale", "layer") {
Component(M1_0, "(root)", "Python", "1 fichiers")
}
}
@enduml
UML 4 · Code
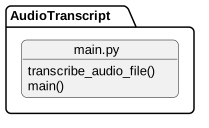
Déclarations, champs et méthodes sélectionnés, regroupés par fichier source. Aucun héritage ni appel n’est déduit. Rendu avec uml-mcp.
Source PlantUML
@startuml
skinparam backgroundColor transparent
skinparam shadowing false
skinparam roundCorner 10
skinparam defaultFontName Arial
skinparam defaultFontSize 13
skinparam ArrowColor #4e6070
skinparam ArrowFontColor #3d4f5f
skinparam titleFontSize 14
skinparam actorBorderColor #006a62
skinparam actorBackgroundColor #e9f3f4
skinparam usecaseBorderColor #006a62
skinparam usecaseBackgroundColor #e9f3f4
skinparam componentBorderColor #006a62
skinparam componentBackgroundColor #e9f3f4
skinparam interfaceBorderColor #006a62
skinparam interfaceBackgroundColor #ffffff
skinparam nodeBorderColor #4e6070
skinparam nodeBackgroundColor #f4f8fb
skinparam databaseBorderColor #006a62
skinparam databaseBackgroundColor #ffffff
skinparam cloudBorderColor #4e6070
skinparam cloudBackgroundColor #f0f5fa
skinparam artifactBorderColor #006a62
skinparam artifactBackgroundColor #ffffff
skinparam rectangleBorderColor #b0c2d3
skinparam activityBorderColor #006a62
skinparam activityBackgroundColor #e9f3f4
skinparam partitionBorderColor #b0c2d3
skinparam stereotypeCBackgroundColor #ffffff
top to bottom direction
hide empty members
package "AudioTranscript" {
object "main.py" as FN0 {
  transcribe_audio_file()
  main()
}
}
@enduml
7.3. Interface publique
Du code extérieur peut utiliser tout ce qui est listé ici. Le projet déclare aussi 0 types publics.
Ligne de commande 1
Points d’entrée
main.pyfichier d’entrée
7.4. Logique métier
Aucune classe n’a été extraite. Voici les plus gros fichiers source et leurs fonctions.
7.5. Intégrations externes
7.6. Stack et dépendances
Python requirements.txt 5 à l’exécution
Dépendances externes
5 paquets déclarés (5 à l’exécution, 0 pour le développement) dans requirements.txt.
Tableau des paquets 5
| Paquet | Version | Usage | Rôle | Registre |
|---|---|---|---|---|
SpeechRecognition | — | exécution | Library for performing speech recognition, with support for several engines and APIs, online and offline. | pypi.org |
pydub | — | exécution | Manipulate audio with an simple and easy high level interface | pypi.org |
rich | — | exécution | Ligne de commande | pypi.org |
typer | — | exécution | Ligne de commande | pypi.org |
boto3 | — | exécution | Services infonuagiques | pypi.org |
7.7. Pipeline CI/CD
Aucun pipeline CI/CD dans le dépôt. Le code se construit et se lance à la main, comme décrit plus haut.
7.8. Déploiement
Mermaid Schéma de déploiement
flowchart LR
  repo[("Dépôt GitHub")]
  local["Poste local<br/>Python"]
  repo -->|"cloner et lancer"| local
Le dépôt ne contient ni Dockerfile, ni fichier Compose, ni configuration d’hébergement : le code s’exécute sur le poste qui le clone.
7.9. Sécurité
Variables d’environnement 3
La page reprend les noms sans leurs valeurs et souligne ceux qui ressemblent à des secrets.
Rien trouvé pour: Interface privée, Services, Entités, Base de données, Supervision, Tests automatisés.
8. Référence
4 / 4 fichiers admissibles lus (6 dans l’arbre); 0 trop volumineux, 0 échec de lecture et 0 diagnostic de syntaxe.
Ce que couvre l’analyse
Les dossiers connus de dépendances et de compilation, les fichiers d’identifiants et les binaires sont exclus. La collecte couvre les README, les manifestes reconnus et les fichiers source pris en charge.
Les statistiques Linguist couvrent l’ensemble du dépôt et peuvent inclure d’autres langages.
10. Fichiers à lire 2
11. Glossaire
Dépôt
Les fichiers source, la configuration et l’historique versionné d’un projet.
README
Le document d’entrée du dépôt, qui présente généralement son rôle et son installation.
Dépendance
Une bibliothèque, un outil ou un service nécessaire à la compilation ou à l’exécution d’un composant.
Interface en ligne de commande
Une interface textuelle où les commandes et arguments choisissent les opérations. Les codes de retour permettent aux scripts de détecter un succès ou un échec.
12. Références
- antoinebou12. (2026, 5 novembre). AudioTranscript. [Software repository] github.com.
- antoinebou12. (2026, 5 novembre). AudioTranscript: README. [Repository documentation] github.com.
- antoinebou12. (2026, 5 novembre). main.py. [Source file] github.com.
- antoinebou12. (2026, 5 novembre). requirements.txt. [Source file] github.com.
- Boucher, A. (2026, 23 octobre). AudioTranscript : Des segments WAV à la transcription. [Project article] antoineboucher.info.
Les sources sans date de publication indiquent la date de leur dernière vérification, le 5 novembre 2026. Les liens des fichiers conservent la révision inspectée lorsqu’elle est disponible.