Table des matières
Je voulais les pesées dans Home Assistant, à côté du reste des automations de l’appartement — pas une app santé isolée de plus. Ça a mené à maintenir hass_renpho[1] (fork d’une intégration communautaire devenue silencieuse), à passer APKLeaks sur le client Android, à un tableau Lovelace que j’ouvre encore quand l’entraînement ou le sommeil bougent, et à un notebook qui essaie de prévoir le poids à partir de l’historique exporté.
1. Pourquoi pas seulement l’app Renpho
Une balance Renpho à bio-impédance sort bien plus que le poids — IMC, métabolisme de base (BMR), âge corporel, estimations de graisse et de muscle, eau, protéines, indices de graisse viscérale, et une pile de résistances par membre si vous récupérez tout le JSON. Utile seulement si les chiffres vivent là où vous regardez déjà : historiques, automations, et le même esprit lab maison que tout le reste auto-hébergé.
2. Inspiration (sans l’effet de mode)
Le suivi personnel, pour moi, a commencé à peu près quand tout le monde parlait du « Blueprint » de Bryan Johnson et de l’auto-quantification. Je ne vends aucun protocole — l’idée était plus simple : des tendances dans le temps, dans les mêmes conditions, sans paniquer sur un pic un matin. La photo ci-dessous, c’est l’ambiance, pas un conseil médical.
3. D’où vient hass_renpho
Les articles de Neil Allen — rétro-ingénierie de l’app Renpho[2] et Renpho → Home Assistant[3] — ont fait le gros du travail. Le dépôt communautaire neilzilla/hass-renpho[4] a emballé ça dans un composant personnalisé Home Assistant.
Quand l’activité a ralenti et qu’il me fallait plus d’entités, j’ai forké vers antoinebou12/hass_renpho[1]. Le README est franc sur les limites :
Cette intégration vise l’API cloud de l’ancienne app Renpho. Les versions récentes de l’app peuvent ne pas fonctionner ; c’est une intégration de loisir, pas un produit supporté.
Il existe un petit explorateur d’API sur hass-renpho.vercel.app/docs[5] si vous voulez tester le JSON avec vos propres identifiants avant de toucher à HA.
3.1. Ce que fait vraiment le fork
- Connexion au cloud Renpho (
renpho.qnclouds.com) avec courriel et mot de passe (comme l’app mobile). - Interrogation selon un intervalle
refreshdéfini en YAML ou dans l’interface. - Capteurs pour le poids, la composition, les estimations métaboliques, les métadonnées de l’appareil, et les mensurations / objectifs si le compte en a.
- URL
proxyoptionnelle quand l’IP de la maison est ralentie ou bloquée alors que l’app marche en données cellulaires.
J’ai continué d’échanger avec le mainteneur d’origine quand c’était utile — partager les formes de payloads, éviter les correctifs en double, garder une intégration utile pour tous ceux qui ont une balance dans le placard.
4. Installation que j’ai suivie
- HACS[6] sur Home Assistant (ou copier
custom_components/renphodepuis le dépôt). - Mettre les identifiants dans
configuration.yaml(style plateforme historique dans mon fork) :
renpho:
  email: [email protected]
  password: !secret renpho_password
  refresh: 600  # secondes entre deux interrogations — se connecter ici peut déconnecter l’app
  # proxy: http://127.0.0.1:8080  # optionnel — seulement le trafic de cette intégration

sensor:
  - platform: renpho
- Redémarrer HA, vérifier que les entités apparaissent, puis construire Lovelace.
Attention : l’interrogation vous connecte à l’API cloud ; Renpho peut fermer la session du téléphone. J’ai choisi un refresh de 600 s pour ne pas marteler la connexion à chaque déclenchement d’automation.
5. Métriques exposées par l’intégration
Le fork documente des dizaines de champs. En pratique, j’en surveille un sous-ensemble dans Lovelace ; le reste sert si vous automatisez ou déboguez.
| Groupe | Exemples | Unités |
|---|---|---|
| Base | poids, IMC, graisse corporelle, eau, muscle, os | kg, % |
| Silhouette | tour de taille, hanches, stature | cm |
| Métabolisme | BMR, protéines | kcal/jour, % |
| Âge | âge corporel | ans |
| Viscéral / sous-cutané | visfat, subfat | niveau, % |
| Appareil | nom de la balance, MAC, modèle, fuseau horaire | texte |
| Bio-impédance brute | résistance par membre (champs de type 20 kHz / 100 kHz) | ohms |
Les tableaux complets sont dans le README du dépôt — pratique quand APKLeaks révèle une nouvelle clé et qu’il faut le capteur correspondant.
Les enregistrements bruts derrière ces capteurs vont plus loin que le tableau. Chaque pesée de mon export a des champs par segment (bodyfat_* et sinew_* pour chaque bras, chaque jambe et le tronc), un left_weight / right_weight séparé, deux séries de résistances par segment nommées resistance20_* et resistance100_*, plus heart_rate, cardiac_index, body_shape et un score. Les mensurations viennent d’une liste séparée avec une paire *_value / *_unit par zone (cou, épaules, poitrine, taille, abdomen, hanches, bras, cuisse, mollet, variantes gauche et droite, rapport taille-hanches) et quelques emplacements personnalisés. Les objectifs forment une troisième liste : un enregistrement par type de mensuration, avec valeurs initiale, cible et finale et leurs horodatages.
6. Quand l’API cloud se bat avec votre réseau
L’IP de sortie résidentielle ou de centre de données échoue parfois face au cloud Renpho alors que l’app officielle marche en LTE. Symptômes : erreurs d’authentification, listes vides, échecs HTTP aléatoires dans les journaux de HA.
Pistes du README :
- VPN sur l’hôte HA — change l’IP de sortie de tout ce qui tourne sur cette machine.
proxydans la config — seul le trafic Renpho passe par votre proxy HTTP/SOCKS (les identifiants transitent par ce chemin — utilisez quelque chose de confiance).
J’en parle parce que ça m’a coûté une soirée qui ressemblait à une « intégration cassée » mais qui était en fait une question de réputation d’IP.
7. Rétro-ingénierie avec APKLeaks
Renpho ne publie pas de PDF d’API. Étape suivante : voir ce que l’APK Android appelle.
APKLeaks[7] cherche des chaînes dans le paquet — hôtes, chemins, clés — sans session de décompilation complète :
pip install apkleaks
git clone https://github.com/dwisiswant0/apkleaks
cd apkleaks && pip install -r requirements.txt
apkleaks -f /chemin/vers/renpho.apk -o renpho-leaks.txt
J’ai fait correspondre les URL et noms de paramètres trouvés aux champs JSON que l’intégration mappait déjà, puis comblé les trous quand Lovelace affichait unknown pour une nouvelle clé après une mise à jour de l’app.
Pour aller plus loin :
Considérez tout ce que vous extrayez comme un contrat instable — les mises à jour de l’app cassent les intégrations maison ; c’est la taxe du loisir.
8. Tableaux Lovelace
Deux vues que j’utilise vraiment : signes vitaux et historique, puis mensurations et objectifs quand Renpho les synchronise.
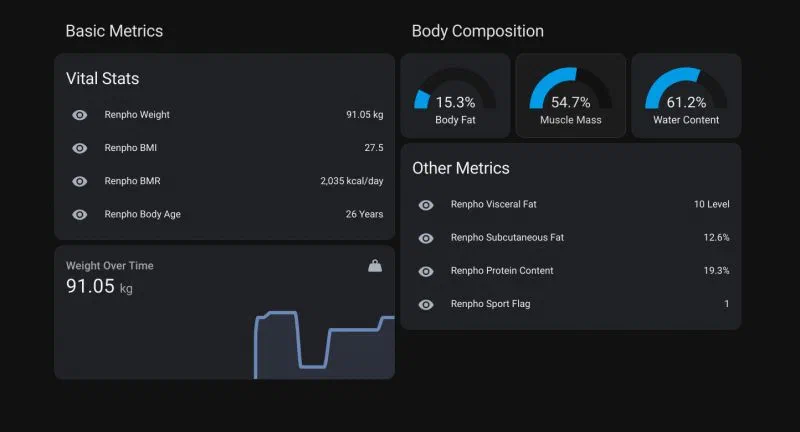
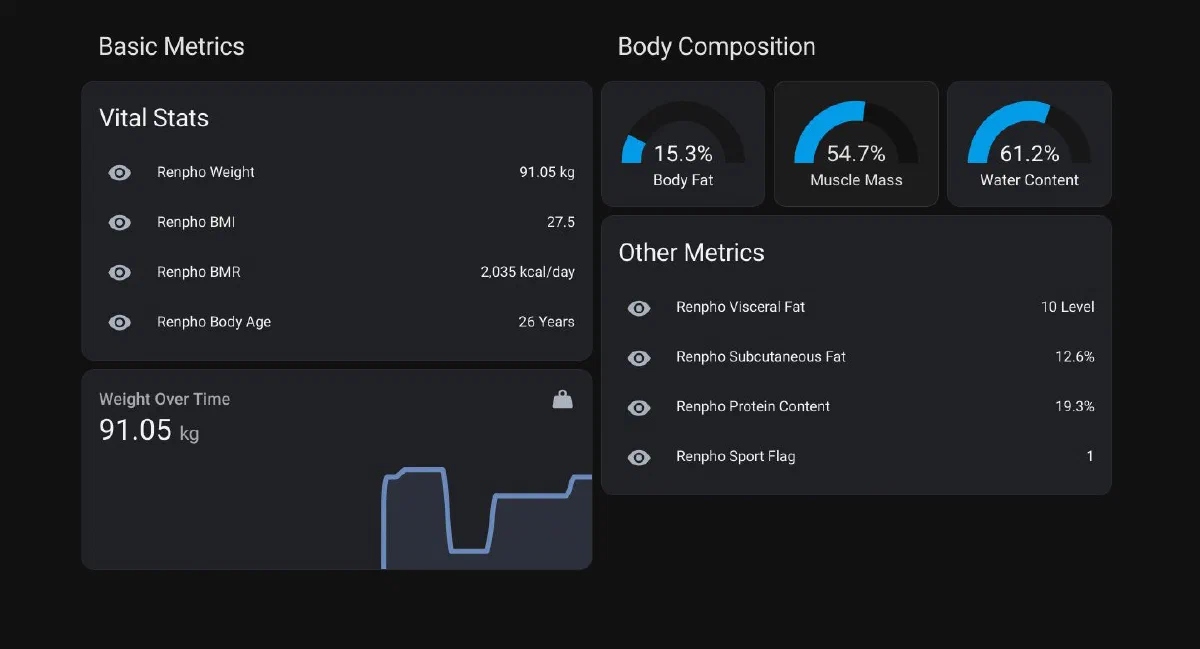
Tendance du poids en haut, jauges de composition au milieu, métriques « extra » en entités que vous pouvez masquer si elles font du bruit.
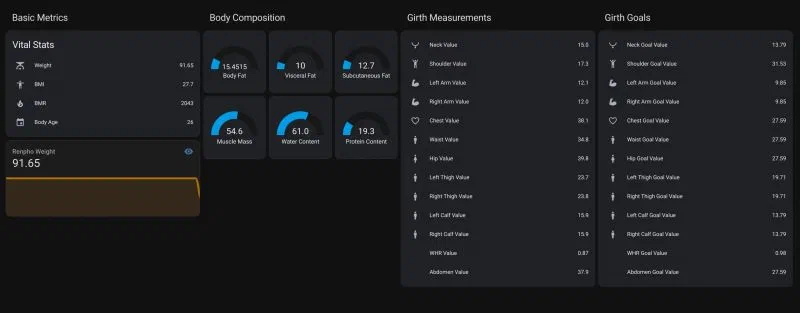
Les mensurations et objectifs ne comptent que si votre profil Renpho en contient ; sinon ce panneau reste vide, et c’est très bien.
9. Prévoir le poids à partir de l’export
Une fois l’historique sorti de l’app, je voulais voir ce qu’un modèle en ferait. Le notebook utilise simplement pandas, scikit-learn, TensorFlow/Keras et keras-tuner. Il ne modélise que le poids : les listes de mensurations et d’objectifs sont chargées mais jamais utilisées comme variables.
9.1. Préparer la série
- Enregistrer les listes JSON brutes renvoyées par l’API (pesées, mensurations, objectifs) dans des fichiers locaux et charger les pesées dans un DataFrame.
- Garder un seul identifiant d’utilisateur. Les enregistrements portent un identifiant par utilisateur, donc une balance partagée ne mélange pas les personnes.
- Convertir
created_at(une chaîne avec décalage UTC), trier dessus, retirer le fuseau horaire pour éviter les incohérences en comparant et en traçant les dates, et ajouter une colonne de date ordinale pour les modèles de référence.
9.2. Deux modèles de référence
- Régression linéaire sur la date ordinale : une droite de tendance prolongée 30 jours après la dernière pesée, avec les valeurs du lendemain et à +30 jours mises en évidence sur le graphique.
- Forêt aléatoire (100 arbres) sur des variables polynomiales de degré 2 de la date, avec une courbe de prédiction quotidienne pour le mois suivant.
Les deux utilisent train_test_split avec un mélange aléatoire, ce qui n’est pas le bon découpage pour une série temporelle (voir les limites plus bas).
9.3. Le LSTM
Les poids sont ramenés entre 0 et 1 avec MinMaxScaler, puis découpés en fenêtres glissantes : les look_back pesées précédentes forment l’entrée, la pesée suivante est la cible.
def create_dataset(dataset, look_back=1):
    X, Y = [], []
    for i in range(len(dataset) - look_back - 1):
        X.append(dataset[i:(i + look_back), 0])
        Y.append(dataset[i + look_back, 0])
    return np.array(X), np.array(Y)

X, Y = create_dataset(scaled_weights, look_back=30)
X = np.reshape(X, (X.shape[0], 1, X.shape[1]))   # (échantillons, 1 pas de temps, 30 variables)
Le premier modèle est volontairement petit : LSTM(4) puis Dense(1), erreur quadratique moyenne, Adam, taille de lot 1, jusqu’à 100 époques avec arrêt anticipé sur la perte d’entraînement (patience 2). Cette fois, le découpage est chronologique : les premiers 67 % pour l’entraînement, le reste pour le test. Les prédictions sont remises en kilogrammes avant de calculer la RMSE d’entraînement et de test.
La deuxième passe élargit la fenêtre à 60 pesées et laisse keras-tuner choisir le nombre d’unités et le taux d’apprentissage :
def build_model(hp):
    model = Sequential()
    model.add(LSTM(units=hp.Int('units', min_value=4, max_value=64, step=4),
                   input_shape=(1, look_back)))
    model.add(Dense(1))
    model.compile(loss='mean_squared_error',
                  optimizer=Adam(hp.Choice('learning_rate', values=[1e-2, 1e-3, 1e-4])))
    return model

tuner = kt.RandomSearch(build_model, objective='val_loss',
                        max_trials=5, executions_per_trial=3)
Cinq essais ont tourné, chacun moyenné sur trois exécutions, avec arrêt anticipé sur la perte de validation (patience 5). La meilleure configuration : 52 unités avec un taux d’apprentissage de 1e-3, et le seul essai à 1e-4 a obtenu le pire score. Le modèle gagnant est reconstruit, réentraîné, puis déroulé pas à pas sur 365 pas : chaque prédiction est ajoutée à la fenêtre et la valeur la plus ancienne en sort.
9.4. Les limites que je corrigerais aujourd’hui
- Découpage aléatoire sur une série temporelle. La régression linéaire et la forêt aléatoire mélangent les dates, donc le jeu de test se retrouve entre des points d’entraînement. Utilisez un découpage chronologique ou
TimeSeriesSplit(importé dans le notebook, jamais utilisé). - Les arbres n’extrapolent pas. Une forêt aléatoire prédit des moyennes de cibles vues à l’entraînement : après la dernière date, sa « prévision » est une ligne plate. Des variables polynomiales d’une seule date n’y changent rien.
- Les pas sont des pesées, pas des jours. Une fenêtre de 30, ce sont les 30 dernières pesées, peu importe les jours, alors que la prévision est tracée à un pas par jour. Rééchantillonnez d’abord en série quotidienne.
- Le LSTM ne voit jamais de séquence. Avec une entrée de forme
(1, look_back), la fenêtre est un seul pas de temps avec 30 ou 60 variables, donc la récurrence ne sert à rien. C’est la forme(look_back, 1)qui lui fait lire la fenêtre dans l’ordre. - Normalisation ajustée avant le découpage, et le tuner utilise le jeu de test comme validation : il ne reste aucune donnée que la sélection de modèle n’a pas touchée.
- Une prévision récursive sur 365 pas accumule ses propres erreurs. Au-delà de quelques semaines, lisez-la comme une forme, pas comme un chiffre.
Rien de tout ça ne remplace le tableau d’habitudes plus bas : des pesées régulières comptent plus pour la courbe que le modèle posé dessus.
10. Contexte hors HA
Renpho n’est qu’une source. Je suis encore l’activité et l’alimentation ailleurs (Google Health, MyFitnessPal) pour que les pesées soient à côté du mouvement et des calories, pas seules dans le vide.
10.1. Habitudes qui ont gardé la série exploitable
| Habitude | Pourquoi |
|---|---|
| Même moment de la journée | Le matin, hydratation semblable — sinon on compare des pommes et de la soupe |
| Vêtements constants | ~1 kg d’écart, c’est du bruit normal, pas « du gras en une nuit » |
| Tendances sur des semaines | La composition estimée par bio-impédance suit la réalité avec du retard ; réagir aux pentes |
| Masquer les jauges ignorées | Si vous n’agissez pas sur le % de graisse viscérale, retirez la carte |
C’était un projet technique en parallèle, c’est devenu une habitude stable : assez de signal pour voir quand l’entraînement ou le sommeil se reflètent dans le poids et l’énergie, pas assez de précision pour des décisions cliniques.
11. Quand s’abstenir
- Vous avez besoin d’une composition corporelle clinique — une balance grand public estime, elle ne diagnostique pas.
- Vous ne pouvez pas utiliser le chemin ancienne app / API qu’attend l’intégration.
- Vous ne maintiendrez pas de fork quand Renpho changera l’app — prévoyez la casse.
- Le % de graisse quotidien va gâcher votre humeur — épurez le tableau sans pitié.
- Vous comptez partager des exports. Un enregistrement brut contient la date de naissance, le sexe, la taille, un identifiant d’utilisateur et l’adresse MAC de la balance à côté des valeurs corporelles ; retirez-les avant que quoi que ce soit quitte votre machine.
12. Liens du dépôt (rapide)
| Ressource | URL |
|---|---|
| Mon fork | github.com/antoinebou12/hass_renpho[1] |
| Lignée amont | github.com/neilzilla/hass-renpho[4] |
| Docs API / bac à sable | hass-renpho.vercel.app/docs[5] |
| Blog de rétro-ingénierie d’origine | neilgaryallen.dev — série Renpho[2] |
13. Articles liés
- Évolution du réseau maison — même fil « maîtriser son infra »
- Notes homelab MediaBox — une autre pile auto-hébergée à la maison
- Économie des LEGO avec la science des données — un autre projet de curiosité sur des données
Si vous auto-hébergez des données de santé, qu’est-ce qui a vraiment tenu — Home Assistant, Grafana, ou les apps mobiles seules ? Le gadget est rarement la partie difficile ; c’est la routine qui l’est.