Aller au contenu
← Tous les articles
Article

Dans BatchBacktesting : parallélisme, hypothèses et résultats exploitables

Écouter en version balado

BatchBacktesting : lire les hypothèses, pas seulement les graphiques · 2:18 · voix synthétiques, script rédigé avec l’IA

Transcription

Sylvie : Un piège classique en analyse de données : prendre le meilleur de chaque colonne et présenter ça comme un seul résultat. Sauf que cette ligne-là n'a jamais existé.

Thierry : Comment est-ce que ça arrive ?

Sylvie : Ça vient d'un projet Python, BatchBacktesting, du groupe AlgoETS. Antoine a lu le code source pour comprendre ce qu'il fait vraiment. Dans le script d'analyse, on regroupe par instrument et on prend le maximum. Chaque colonne a son maximum indépendant, donc la ligne obtenue peut mélanger rendement, baisse maximale et durée de runs différents.

Thierry : Il faut donc choisir une vraie ligne d'abord.

Sylvie : Oui, par exemple selon le rendement, et seulement ensuite parler de sa baisse. Antoine précise que c'est une observation de lecture de code, pas une mesure.

Thierry : Et le moteur, il fait quoi concrètement ?

Sylvie : C'est un petit pipeline de données. On donne une liste d'instruments et une stratégie. Pour chaque instrument : récupération des prix, nettoyage, backtest, écriture des résultats. Le tout dans un pool de threads, avec quatre workers par défaut pour le mode une stratégie.

Thierry : C'est une promesse de vitesse ?

Sylvie : Non, et il le dit : ce sont des valeurs par défaut du code, pas un débit mesuré. Même chose pour les hypothèses : cent mille de capital de départ, zéro virgule deux pour cent de commission, ordres exclusifs. Elles sont dans le constructeur, donc à garder à côté de toute comparaison de rendements.

Thierry : Et le slippage ?

Sylvie : Pas couvert. Slippage, ventes à découvert, titres retirés de la cote, opérations sur titres : tout ça demande une revue à part. Autre détail : la stratégie EMA calcule trois moyennes, vingt, quatre-vingts et cent cinquante, mais les entrées ne comparent que les deux premières.

Thierry : Et quand ça plante ?

Sylvie : Un instrument en échec ne renvoie rien. Si tous échouent, l'étape suivante n'a plus rien à assembler. Et l'aide multi-stratégies imbrique des pools dans un pool, donc attention aux limites des API.

Thierry : Ce qu'on retient : lire les hypothèses avant les courbes.

Sylvie : Voilà. Antoine n'a relancé aucune simulation ni avancé de nouveaux chiffres de rendement. L'article complet a le diagramme et les liens vers le code.

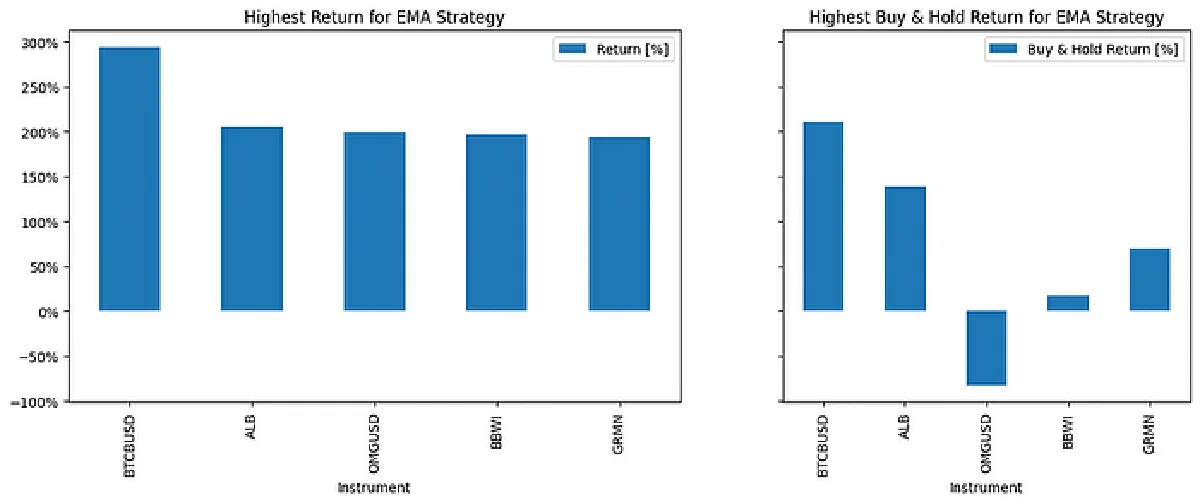
Graphique de traitement par lots déjà publié dans l’article sur les indicateurs
Table des matières

Un backtest par lots est un petit pipeline de données : choisir les instruments, obtenir les prix, nettoyer les observations, exécuter une stratégie et conserver des résultats comparables. AlgoETS/BatchBacktesting rend ces étapes visibles dans le code Python.

Cette illustration provient d’un article existant. Ce n’est pas un nouveau résultat de simulation.

1. Suivre un instrument

Dans src/BatchBacktesting.py[1], process_instrument choisit un adaptateur de prix pour action ou crypto, nettoie les données et construit un Backtest. Il ajoute ensuite le nom de l’instrument et de la stratégie au résultat.

flowchart TD
  I["Liste d’instruments et stratégie"] --> P["ThreadPoolExecutor"]
  P --> D["Récupérer et nettoyer les prix"]
  D --> B["Backtest par instrument"]
  B --> R["Résultat avec Instrument et Strategy"]
  R --> C["CSV par instrument"]
  R --> A["CSV agrégé par stratégie"]
  B --> H["Graphique HTML facultatif"]

Le runner d’une stratégie utilise quatre workers par défaut. Les graphiques sont facultatifs. Ce sont des paramètres du code, pas des mesures de performance.

2. Les hypothèses sont dans le constructeur

Le runner inspecté fixe 100 000 de capital initial, une commission de 0,002, soit 0,2 %, et des ordres exclusifs. Une comparaison de rendement doit conserver ces hypothèses.

Elles ne couvrent pas tous les coûts ni les problèmes de données. Le glissement de prix, la disponibilité des ventes à découvert, les titres radiés et les opérations sur titres demandent une vérification distincte.

3. Un détail de la stratégie EMA

Dans strategies.py[2], la classe EMA calcule les périodes 20, 80 et 150. Les conditions d’entrée comparent les courbes 20 et 80. La courbe 150 est calculée, mais n’intervient pas dans ces conditions.

La règle d’achat ferme la position précédente, puis fixe un stop à 90 % du prix et une cible à 125 %. Cela décrit l’expérience implémentée, pas des paramètres optimaux.

4. Conserver de vraies lignes de résultats

Le code écrit un CSV par instrument, un CSV agrégé par stratégie et des graphiques HTML facultatifs. Le README renvoie à un exemple EMA sur AAPL du 4 avril 2018 au 3 avril 2023. Ces dates concernent cet exemple, pas tous les runs.

Ouvrir le graphique AAPL publié[3].

Dans analyse.py[4], groupby("Instrument").max() prend le maximum de chaque colonne indépendamment. La ligne obtenue peut mélanger plusieurs simulations. Il vaut mieux sélectionner une vraie ligne selon son rendement avant d’en commenter la durée et le drawdown.

5. Comprendre les limites d’exécution

Un instrument en échec renvoie None. Si tous échouent, la concaténation finale n’a aucun résultat à assembler. Le helper multi-stratégies ajoute aussi un pool externe autour des pools internes : limites API et concurrence imbriquée méritent donc de l’attention.

Ces constats viennent de la lecture du code. Aucun nouveau backtest ni rendement n’a été produit pour cet article.

6. Sources et articles liés

Références

  1. AlgoETS. (). src/BatchBacktesting.py. [Source file or documentation] github.com.
  2. AlgoETS. (). strategies.py. [Source file or documentation] github.com.
  3. Ouvrir le graphique AAPL publié. (). [Web page] algoets.github.io.
  4. AlgoETS. (). analyse.py. [Source file or documentation] github.com.
  5. AlgoETS. (). BatchBacktesting. [Software repository] github.com.

Les références utilisent la date de publication de cet article.