Table des matières
AINewsTracker transforme les actualités financières en données consultables, analysables et comparables aux données de marché.
Le projet est un service FastAPI avec des routes distinctes pour les actualités, les articles, les entreprises, les utilisateurs, l’amorçage des données et les stratégies de négociation. Les routes reçoivent les requêtes HTTP; les services et les dépôts prennent en charge l’analyse et le stockage.
1. Du flux à l’article
Une requête lance la collecte. Le service d’actualités récupère le contenu des flux et crée les articles. Le service de mesures analyse le texte, puis le dépôt d’articles enregistre le résultat dans MongoDB.
| Responsabilité | Fichier source |
|---|---|
| Recevoir la requête | app/routers/news.py |
| Collecter les actualités | app/core/services/news.py |
| Analyser le texte | app/core/services/metrics.py |
| Stocker les articles | app/core/repo/article.py |
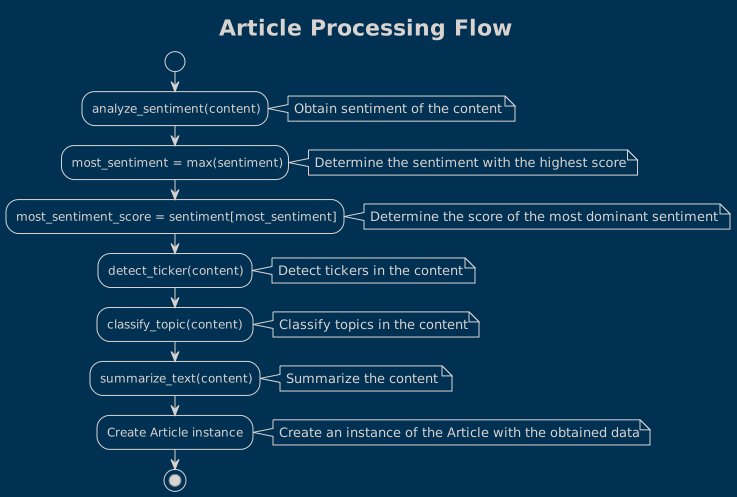
AlgoETS. (2026, 5 novembre). Article processing flow. AINewsTracker repository, docs/diagrams/out/article_processing_flow.svg.
Diagramme de traitement original[1].

Les routes définissent l’interface HTTP, les modèles décrivent les données, les services traitent les actualités et les dépôts isolent l’accès à la base. app/main.py configure aussi le cache Redis.
2. Garder la source avec l’analyse
L’aperçu des données[2] relie quatre objets : une source produit des articles, les commentaires appartiennent à un article et les entreprises identifient les sociétés mentionnées. La source porte notamment la langue et le pays. L’article conserve son URL, sa date et son texte avec les champs d’analyse.
Cette séparation facilite la vérification. On peut remonter d’un sentiment à l’article et à son éditeur. Le symbole boursier permet de rapprocher les mentions d’une entreprise sans traiter chaque variante de son nom comme une société différente.
3. Les résultats de l’analyse de texte
La documentation illustre un sentiment et son score, des symboles boursiers détectés, un résumé et des sujets. Ces champs répondent à des questions différentes : de quelle entreprise parle-t-on, que dit l’article et comment son texte est-il classé ? Les exemples expliquent le modèle, tandis que les classes Pydantic définissent les champs réels.
Je comparerais ces résultats au texte original avant de les utiliser dans une stratégie. Un résumé peut omettre une condition. La mention d’une entreprise ne suffit pas à établir un événement exploitable en bourse. L’URL et la date doivent donc rester accessibles pendant la vérification.
4. Analyse et backtesting
La documentation décrit l’analyse de sentiment, la classification par sujet, l’attribution de tickers et le résumé d’articles. La route de stratégie transmet les demandes de backtest à app/core/trading/strategy.py.
Ces étiquettes restent des données d’entrée pour une expérience. Elles ne prouvent pas qu’une actualité a causé un mouvement de marché, et un backtest historique ne garantit pas les résultats futurs.
Pour examiner une expérience, je distingue les étapes suivantes :
| Étape | Éléments à vérifier |
|---|---|
| Collecte | Éditeur, URL, date de publication et texte récupéré |
| Analyse du texte | Entreprises détectées, étiquettes et résumé comparés à l’article |
| Entrée de stratégie | Observations disponibles au moment testé |
| Résultat du backtest | Période, hypothèses et résultat annoncé par la stratégie |
Cette grille décrit la façon dont j’évaluerais une expérience construite sur le service. Elle ne présente aucune mesure de précision prédictive ou de rendement.
5. Lire l’architecture
Le GitDiagram complet montre l’enregistrement des routes, les modèles, les dépôts, les scripts d’amorçage, MongoDB, Redis et la branche de stratégie. Chaque nœud renvoie à son fichier source.